3 条题解
-
0
枚举+哈希
考场上手残加了个链表,挂到78,就过来写反思了反思
- WA:枚举答案要枚举到n,因为答案有1的情况(
场上写的到n/2) - TLE:哈希不用加链表,直接判就可以
code
bool M1; #include <bits/stdc++.h> using namespace std; #define ll long long #define ull unsigned long long #define deb(x) cerr<<"l: "<<__LINE__<<" "<<#x<<"="<<x<<'\n' #define look_memory cerr<<abs(&M2-&M1)/1024.0/1024<<"MB\n" namespace syr { ll read() { ll x=0, f=1; char c = getchar(); while (c<'0' || c>'9') { if (c=='-') f=-1; c = getchar(); } while (c>='0' && c<='9') { x = x*10 + c-'0'; c = getchar(); } return x*f; } const ll N = 2e5+10; const ull M = 13331; ll n, ans, cnt, mid, r; ll a[N], res[N]; ull ta[N], tb[N], ff[N]; map <ull, ll> m; ll check (ll x) { m.clear(); ll cnt=n/x; for (ll i=x; i<=n; i+=x) { ll l=i-x+1, r=i; ull wa = ta[r]-ta[l-1]*ff[x]; ull wb = tb[l]-tb[r+1]*ff[x]; if (m[wa] == 1 || m[wb] == 1) cnt--; m[wa] = 1; } return cnt; } void work() { n = read(); ff[0] = 1; for (ll i=1; i<=n; i++) ff[i]=ff[i-1]*M; for (ll i=1; i<=n; i++) { a[i] = read(); ta[i] = ta[i-1]*M+a[i]; } for (ll i=n; i>=1; i--) tb[i] = tb[i+1]*M+a[i]; //枚举 for (ll i=1; i<=n; i++) { if (n/i<ans) break; ll t = check(i); if (t>ans) { ans = t; res[cnt=1] = i; }else if (t==ans) res[++cnt] = i; } cout<<ans<<" "<<cnt<<'\n'; for (ll i=1; i<=cnt; i++) cout<<res[i]<<" "; } } bool M2; int main() { cin.tie(0)->sync_with_stdio(0); look_memory; syr::work(); return 0; } - WA:枚举答案要枚举到n,因为答案有1的情况(
-
-1
这个题做法比较简单,就是正反一下然后,用判是否存在就好
然后时间复杂度是
map
1.为什么会
先放个图
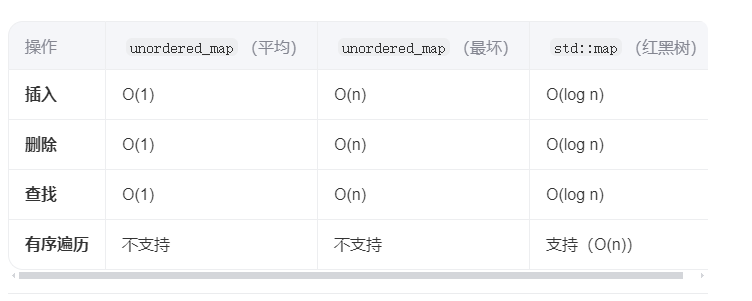
我们可以发现当插入的数很多的时候,unordered_map并不优于map
对于这个题
我们check的时候会插入很多互不相同的数,这样导致了他的复杂度急速上升,然后我们就t了
2.怎么避免
有两种方法,一种是在check里面定义unordered_map,unordered_map初始时是清空的,函数跑完之后unordered_map也释放了,这样是不会t的,但是你如果用clear(),他就会很慢,会t;第二种是用map,因为这个题他n是2e5范围的,所以我们可以放心使用map,复杂度是的,每次check完清空map,也是能通过这个题的,
而且好像跑的很快
- 1
