1 条题解
-
1
豆包评价:这道题是 CSP-S 2022 的压轴题(T4),核心定位是「树形 DP 综合应用题」,对考生的建模能力、状态设计和逻辑严谨性要求极高,是当年区分高水平选手的关键题目。
首先我们考虑暴力怎么做
当 ,直接加起来所有的权值
当 ,首先可以注意到跳到链外是不优的!很好理解:
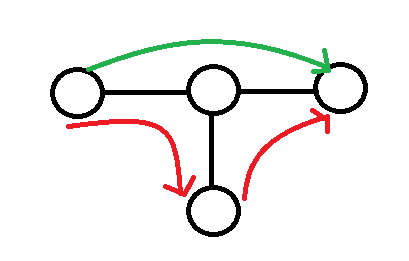
那我们就可以将整条 到 的链抽出来,在上面选出来一个子序列,使其最小,显然可以dp,设 表示在 这个节点的最小值,则有转移:
时间复杂度 , 为链长,在随机数据下可通过
当 我们发现我们对于一个点 如果跳到链外一个点 ,且其第一个在链上的祖先为 ,那么可以发现这个 一定为 一级儿子,且 最小
显然要有 最小
很好理解如果是 的二级儿子肯定不优秀:
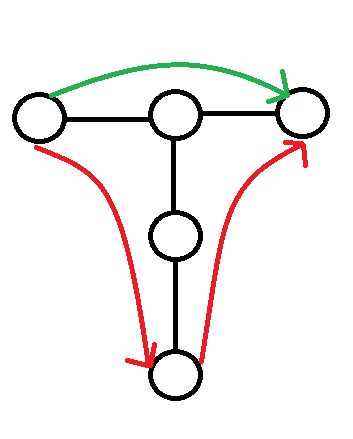
所以对于一个节点 ,仅有两种可能,要么在 点,要么在 的儿子处
所以还是可以dp,设 表示在 号节点的 自己/儿子 的位置
那么则有转移:
$$dp_i=\min \{ dp_{i-1,0},dp_{i-1,1},dp_{i-2,0},dp_{i-2,1},dp_{i-3,0} \}+a_i $$$$dp_{i,1}=\min \begin{cases}dp_{i,0}+num_i \\\min \{ dp_{i-1,0},dp_{i-1,1},dp_{i-2,0} \}+num_i\end{cases} $$时间复杂度 , 为链长
接下来考虑优化,使用矩阵加速递推!
如果我们使用矩阵优化的话,对于 的情况,我们要记录 个变量, 也非常艰难能过去,所以先考虑优化dp状态
我们发现对于两个点 、 之间能否互相跳,仅仅与他们之间的距离有关,所以考虑把距离放进dp状态里
设 表示跳到距离 节点长度为 的节点位置的最小值,注意到 只用取
然后我们进行转移:
$$dp_{i,0}=\min \{ dp_{i-1,0},dp_{i-1,1},dp_{i-1,2} \}+a_i $$$$dp_{i,1}= \min \begin{cases}dp_{i,0}+num_i \\\min \{ dp_{i-1,0}+dp_{i-1,1} \}+a_i \\dp_{i-1,1}\end{cases} $$这个式子有些 的状态没有转移是因为 的状态已经全部包含了
这样就可以把时间复杂度优化到 了
然后推矩阵:
首先 :
$$\begin{bmatrix}w_i & \infty & \infty \\\infty & 0 & \infty \\\infty & \infty & 0\end{bmatrix}\begin{bmatrix}dp_{i-1}\\0\\0\end{bmatrix}=\begin{bmatrix}dp_{i}\\0\\0\end{bmatrix} $$:
$$\begin{bmatrix}w_i & w_i & \infty \\0 & \infty & \infty \\\infty & \infty & 0\end{bmatrix}\begin{bmatrix}dp_{i-1}\\dp_{i-2}\\0\end{bmatrix}=\begin{bmatrix}dp_{i}\\dp_{i-1}\\0\end{bmatrix} $$:
$$\begin{bmatrix}w_i & w_i &w_i \\0 & num_i & num_i+w_i \\\infty & 0 & \infty\end{bmatrix}\times\begin{bmatrix}dp_{i-1,0}\\dp_{i-1,1}\\dp_{i-1,2}\end{bmatrix}=\begin{bmatrix}dp_{i,0}\\dp_{i,1}\\dp_{i,2}\end{bmatrix} $$我们把路径上第 个点的转移矩阵称为 。根据动态 DP 的套路,设路径长度为 ,整个转移过程如下:
$$\begin{aligned} \begin{bmatrix}dp_{k,0}\\dp_{k,1}\\dp_{k,2} \end{bmatrix}&=base_k\times \begin{bmatrix}dp_{k-1,0}\\dp_{k-1,1}\\dp_{k-1,2} \end{bmatrix}\\ &=base_k\times base_{k-1}\times \begin{bmatrix}dp_{k-2,0}\\dp_{k-2,1}\\dp_{k-2,2} \end{bmatrix}\\ &\ \ \vdots\\ &=base_{k}\times base_{k-1}\times \cdots \times base_2\times \begin{bmatrix}dp_{1,0}\\dp_{1,1}\\dp_{1,2} \end{bmatrix}\\ \end{aligned} $$所以我们只需自己算出 到 的贡献然后再算出 到 和 到 的贡献即可
然后因为使从 开始,所以从 到 是正着算贡献,然后从 到 是倒着算贡献,所以我们还需预处理出来 的总乘积
这个东西可以使用倍增来预处理,预处理出来 表示从 开始,向上跳 的祖先的 之积,还有一个 表示从 的祖先开始,向下跳 步的 之积
这与预处理倍增LCA是相似的
然后就可以切掉这道题了
#include<algorithm>
#include<iostream>
#include<cstring>
#include<vector>
#include<cstdio>
#define int long long
#define inf 1e18
using namespace std;
bool Test_MLE_start;
constexpr int N=2*1e5+10;
int _=1,n,q,k,w[N],dep[N],num[N],fa[N][20];
vector<int> ve[N];
struct Matrix{
	int res[3][3];
	void inits(){memset(res,0x3f,sizeof(res));}
	friend Matrix operator *(const Matrix A,const Matrix B){//矩阵乘法,把求和改成求min,把乘法改成加法
		Matrix ans;ans.inits();
		for(int i=0;i<3;i++){
			for(int k=0;k<3;k++){
				for(int j=0;j<3;j++){
					ans.res[i][j]=min(ans.res[i][j],A.res[i][k]+B.res[k][j]);
				}
			}
		}return ans;
	}
}idt,base[N],up[N][20],down[N][20];//idt:乘的初始化,up:从u开始往上跳2^j后的矩阵,down:从u的祖先跳到u跳2^j的矩阵
inline int reads(){
	char c=getchar();
	int x=0,f=1;
	while(!isdigit(c)){if(c=='-') f=-1;c=getchar();}
	while(isdigit(c)){x=(x<<3)+(x<<1)+(c^'0');c=getchar();}
	return x*f;
}
inline void files(){
	freopen("std.in","r",stdin);
	freopen("std.out","w",stdout);
}
inline void clr(){
//	Don't forget!

}
bool cmp(int a,int b){return w[a]<w[b];}//按照权值排序求最小
void builds(){
	for(int i=0;i<3;i++){//初始化初始矩阵
		for(int j=0;j<3;j++) idt.res[i][j]=(i==j?0:inf);
	}
	//预处理不同k的矩阵
	if(k==1){
		for(int i=1;i<=n;i++){
			base[i].inits();
			base[i].res[0][0]=w[i],base[i].res[1][1]=0;
		}
	}
	else if(k==2){
		for(int i=1;i<=n;i++){
			base[i].inits();
			base[i].res[0][0]=base[i].res[0][1]=w[i];
			base[i].res[1][0]=base[i].res[2][2]=0;
		}
	}
	else{
		for(int i=1;i<=n;i++){
			base[i].inits();
			base[i].res[0][0]=base[i].res[0][1]=base[i].res[0][2]=w[i];
			base[i].res[1][0]=base[i].res[2][1]=0;
			base[i].res[1][1]=num[i],base[i].res[1][2]=num[i]+w[i];
		}
	}
}
void dfs(int u,int dad){
	for(auto v:ve[u]){
		if(v==dad) continue;
		dep[v]=dep[u]+1,fa[v][0]=u;//预处理dep,fa
		up[v][0]=down[v][0]=base[v];//预处理up,down
		dfs(v,u);
	}
}
Matrix LCA(int u,int v){
	Matrix s1=idt,s2=idt;
	if(dep[u]<dep[v]) s2=base[v],v=fa[v][0];//如果x已经跳的比y高了说明已经跳了一次所以s2设为base[v]
	for(int i=19;i>=0;i--){
		if(dep[fa[u][i]]>=dep[v]) s1=down[u][i]*s1,u=fa[u][i];//倍增跳x
	}if(u==v) return s2*base[u]*s1;
	for(int i=19;i>=0;i--){
		if(fa[u][i]!=fa[v][i]){//倍增跳x,倍增跳y
			s1=down[u][i]*s1,s2=s2*up[v][i];
			u=fa[u][i],v=fa[v][i];
		}
	}return s2*base[v]*base[fa[v][0]]*base[u]*s1;//最后剩下一个点加上
}
int solve(int x,int y){
	if(x==y) return w[x];//如果相等直接返回
	if(dep[x]<dep[y]) x^=y^=x^=y;//如果x的深度比y大,就交换,因为我们跳的是x
	Matrix ret=LCA(fa[x][0],y);//传入fa[x][0]是因为我们使用LCA算的是fa[x][0]~LCA~y的贡献,而我们原来的x~fa[x][0]这一段就没有被算进去
	Matrix now=idt;//now是x~fa[x][0]这一段的贡献,下面是直接手推之后的结果
	if(k==1||k==2) now.res[0][0]=w[x];
	else now.res[0][0]=w[x],now.res[1][0]=w[x]+num[x];
	ret=ret*now;return ret.res[0][0];
}
bool Test_MLE_end;
signed main(){
//	printf("%lf Mb\n",(&Test_MLE_end-&Test_MLE_start-1)/1024.0/1024.0);
//	files();
//	_=reads();
	while(_--){
		clr();n=reads(),q=reads(),k=reads();
		for(int i=1;i<=n;i++) w[i]=reads();
		for(int i=1;i<n;i++){
			int u=reads(),v=reads();
			ve[u].push_back(v),ve[v].push_back(u);
		}for(int i=1;i<=n;i++) sort(ve[i].begin(),ve[i].end(),cmp),num[i]=w[ve[i][0]];
		builds(),dfs(1,0);
		for(int j=1;j<20;j++){
			for(int i=1;i<=n;i++){
				fa[i][j]=fa[fa[i][j-1]][j-1];
				up[i][j]=up[i][j-1]*up[fa[i][j-1]][j-1];
				down[i][j]=down[fa[i][j-1]][j-1]*down[i][j-1];
			}
		}//倍增
		while(q--){
			int x=reads(),y=reads();
			printf("%lld\n",solve(x,y));
		}
	}
	return 0;
}
- 1
